

【JAVA服务端架构】分布式环境下Hilo算法生成自增编号
常见的编号生成策略有以下几种方式:1.数字型自增长,但有时候我们需要编号有一定的长度,并不是像0,1,2,3这种,还有可能会对编号加上一定的前戳2.使用UUID,但是UUID是无序的,毫无意义的字符,
常见的编号生成策略有以下几种方式:
1.数字型自增长,但有时候我们需要编号有一定的长度,并不是像0,1,2,3这种,还有可能会对编号加上一定的前戳
2.使用UUID,但是UUID是无序的,毫无意义的字符,像生成订单号这种就不太适合
3.使用时间戳,但是在高并发的情况下,还是无法能够保证唯一性,哪怕加上随机数,也有一定几率重复
4.使用随机数和自定义字符,但是很多语言的随机数都是伪随机数,例如java的Random,在高并发的情况下游客可能能取出相同的数字
所以,我们需要建立一个系统管理主键表,用来管理主键,对每次取出来的数据进行+1操作,但是这样的话有一个非常大的性能问题,每次生成编号的时候,需要查询这个系统管理主键表,对性能有一定的损耗。所以我们使用Hilo高低位算法来解决这个问题。
生成自增编号保证两点:
1.首先要保证在分布式环境下编号的唯一性
2.其次保证编号可序性,能够通过对数据进行排序
做法如下:
1.唯一性
设:最小低位值10 最大低位值99
(为保证分布式特殊情况,最小低位和最大低位位数要相同)
高位值 编号
1 110
1 111
1 112
1 113
…
1 199
2 210
2 211
2 212
…
2 299
…
11 1110
编号生成方式为:高位 + 低位(注意:+是拼接,不是运算符,保证分布式情况下的唯一性)
2.有序性
数据查询时,可按照高位和编号同时进行升序,或降序排序
对每次从系统管理主键表取出数据时,我们需要同时对数据进行+1操作
具体实现如下:
    //unique _key
    public HiloNumber generate() throws Exception {
        synchronized (HiloOptimizer.class){
            if(!isInitialize){
                throw new Exception("Hilo Service not initialized.");
            }
            //低位进位
            low ++ ;
            if (low > max) { // 当低位超过最大高位
                //获取下一次高位的值
                high = queryNextHigh();
                //低位重置
                low = min;
            }
            //接下来拼接ID,此处使用算法实现,不采用转字符串的形式,提高效率
            //取得低位数字长度
            final long lowLength = getNumberLength(low);
            //高位和低位进行拼接
            final long id=high * (long)Math.pow(10, lowLength) + low;
            //封装返回值对象
            mHiloNumber.setId(id);
            mHiloNumber.setHigh(high);
            return mHiloNumber;
        }
    }
详细代码和示例我会在下面给出,下面让我们来测试一下并发,看看真实环境是怎样的
首先我们建立TestDB实体类对象,模拟系统管理主键表,然后我们建立TestClient客户端对象,模拟客户端获取ID的过程
测试代码如下:
public class HiloTest {
    public TestDB db=new TestDB();
    public void run(){
        ExecutorService fixedThreadPool = Executors.newFixedThreadPool(1);
        for (int i = 0; i < 2; i++) {
            //启动时,查询数据库
            TestClient clinet=new TestClient(this,"客户端"+i);
            fixedThreadPool.execute(clinet);
        }
    }
}
在TestClient中,我们首先初始化HiloOptimizer对象,设置最小低位10,最大低位99,然后获取150次,并打印最终结果,在实际情况中我们需要把拿到的编号和最高位存储到我们需要添加编号的表中,存储最高位是方便我们进行排序使用。
    @Override
    public void run() {
        mHilo = new HiloOptimizer();
        mHilo.init(10,99,this);
        for (int i = 0; i < 150; i++) {
            HiloNumber hiloNumber;
            try {
                hiloNumber =mHilo.generate();
                final long id = hiloNumber.getId();
                final long high= hiloNumber.getHigh();
                System.out.println("客户端:"+clientName+"  高位值:"+high+"  编号:"+id);
            } catch (Exception e) {
                e.printStackTrace();
            }
        }
    }
然后,我们要实现HiloOptimizer的HiloTask接口,在需要进位的时候对系统管理主键表中存储的最高位进行+1并返回
    @Override
    public synchronized long queryNextHigh() {
        synchronized (TestDB.class){
            //从数据库中查询当前数据的高位值
            long high = mTest.db.high;;
            //高位进位
            high = high + 1;
            //更新数据库
            mTest.db.high=(high);
            System.out.println("客户端:"+clientName+" 查询更新:"+high);
            return high;
        }
    }
OK,运行结果如下:
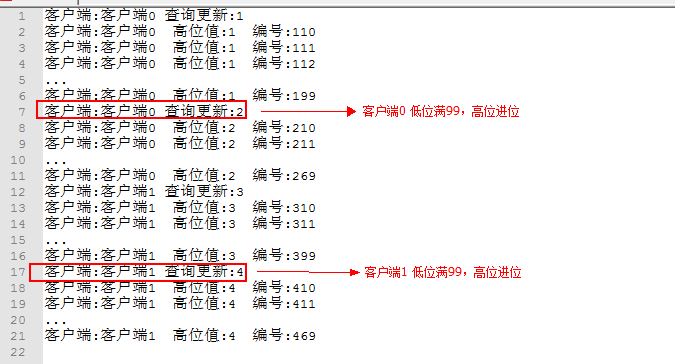
以上结果并没有采用并发来测试,接下来我们在模拟一下并发情况
修改线程池同时执行的线程数,一般情况是依据CPU的核心数来定的,所以我们这里暂且设定为4
ExecutorService fixedThreadPool = Executors.newFixedThreadPool(4);
然后运行,执行结果如下:
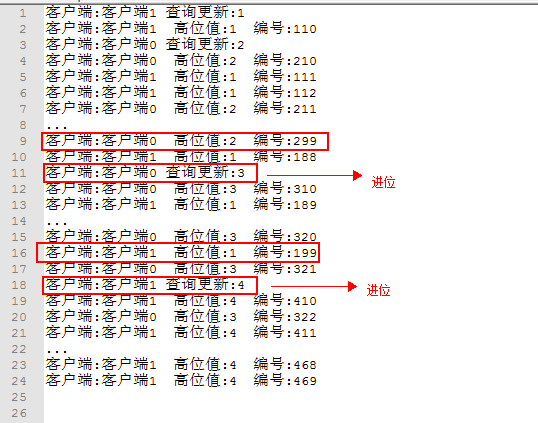
OK,接下来我们模拟一下高并发生成大量的编号,然后把数据导入数据库中,进行排序和查询
首先使用Mysql随意建立一张表,字段就存id,high
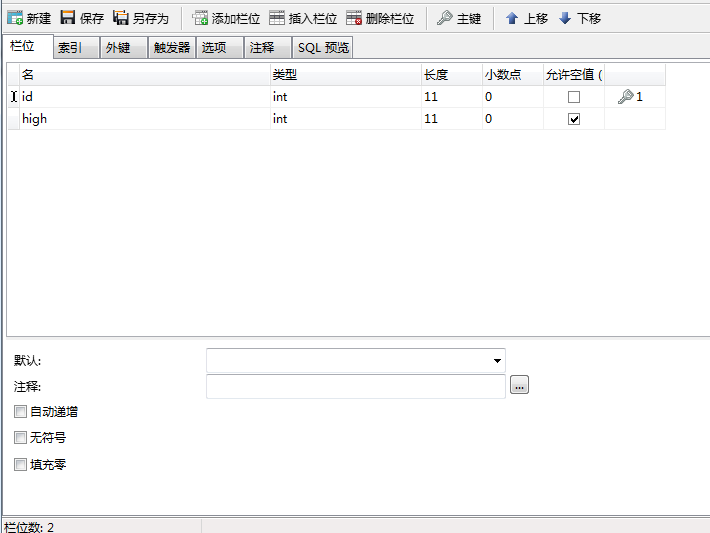
修改打印数据格式:
System.out.println(id+","+high);
然后修改测试客户端数量,改为12
运行,并把结果保存在txt文本文档中
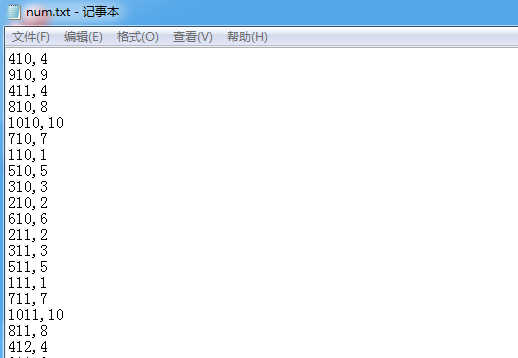
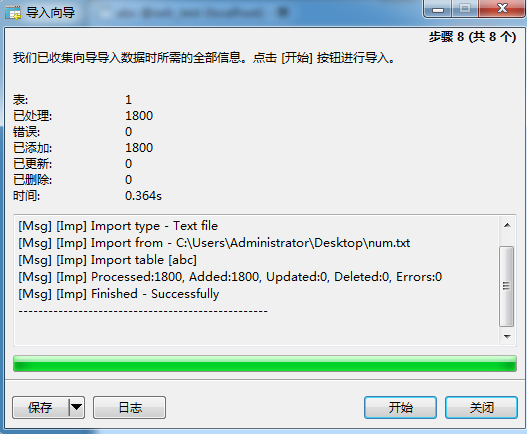
然后将文本文档数据导入到mysql数据库中,如果导入成功,则证明我们生成的编号没有重复,因为id字段是主键,主键不允许重复,如果重复,则会报错
开始导入,此处我使用的可视化的Mysql工具Navicat for MySQL:
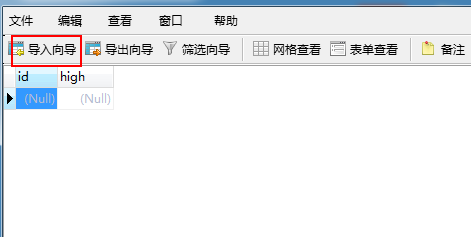
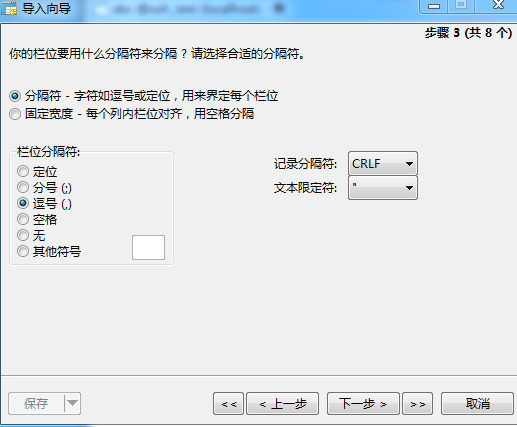
选择文本文档,下一步,然后选择分栏符为逗号
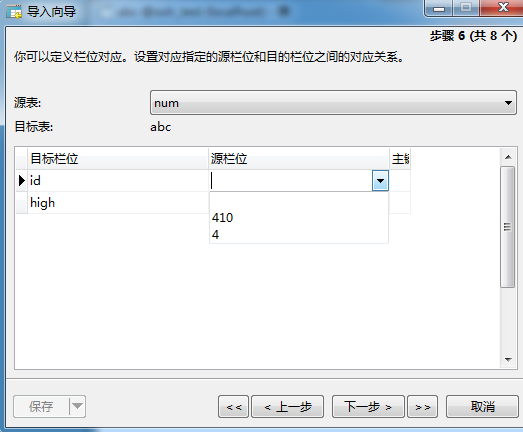
设置导入数据对应的栏位,其中410为编号,4为高位值
选择如下:
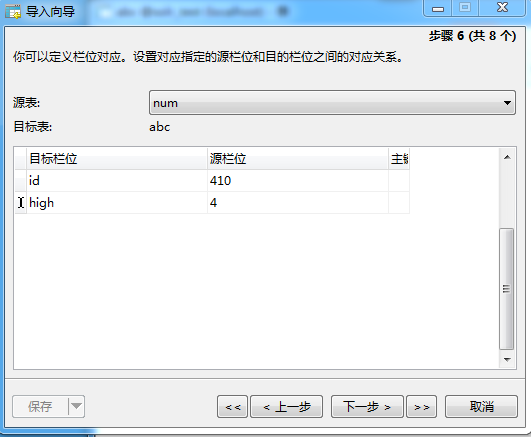
OK,导入成功,一共1800行数据,没有异常,所以我们生成的编号是没有重复的
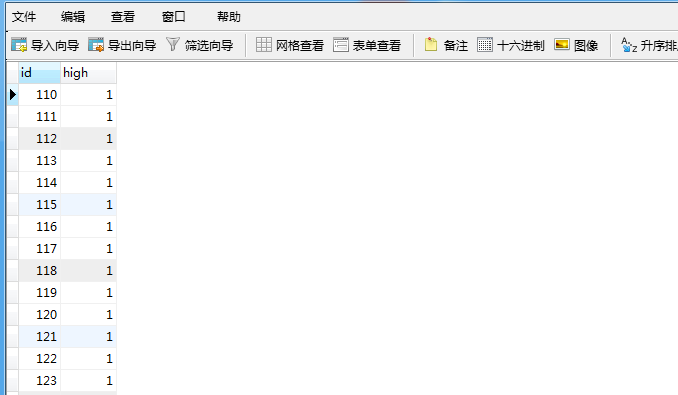
打开表,看到效果如下,注意,此处默认是按照主键升序排序的
 江江于 2026-10-12 13:39:53 修改阅读 2752评论 0点赞 0